Deux conférences d’ai-PULSE 2026 n’avaient rien à voir sur le papier. L’une venait d’AMD et parlait de revendre des tokens. L’autre venait de Nokia et parlait de réseau dans les racks. Mises côte à côte, elles racontent à mon sens la même histoire.
Servir un modèle est facile, en vivre est autre chose
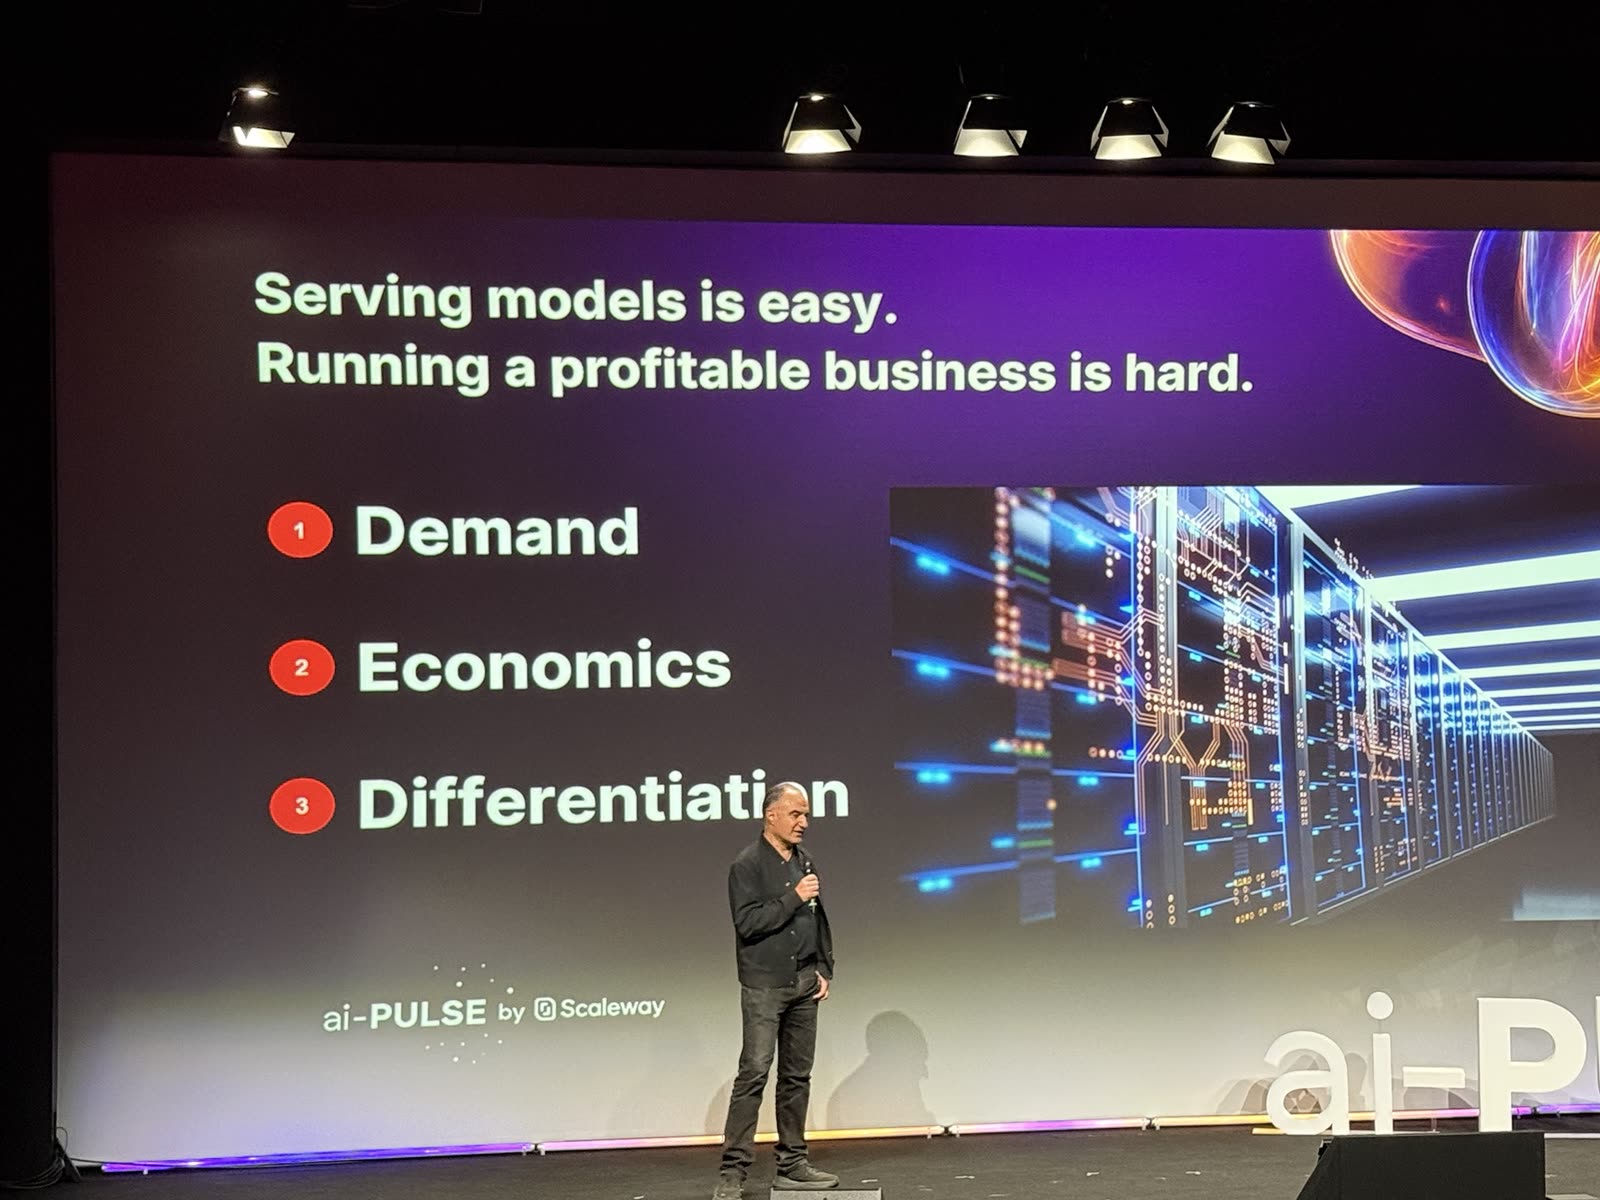
Ramine Roane, CVP Product Application Engineering chez AMD, a ouvert avec une phrase qui résume le sujet : « Serving models is easy. Running a profitable business is hard. »
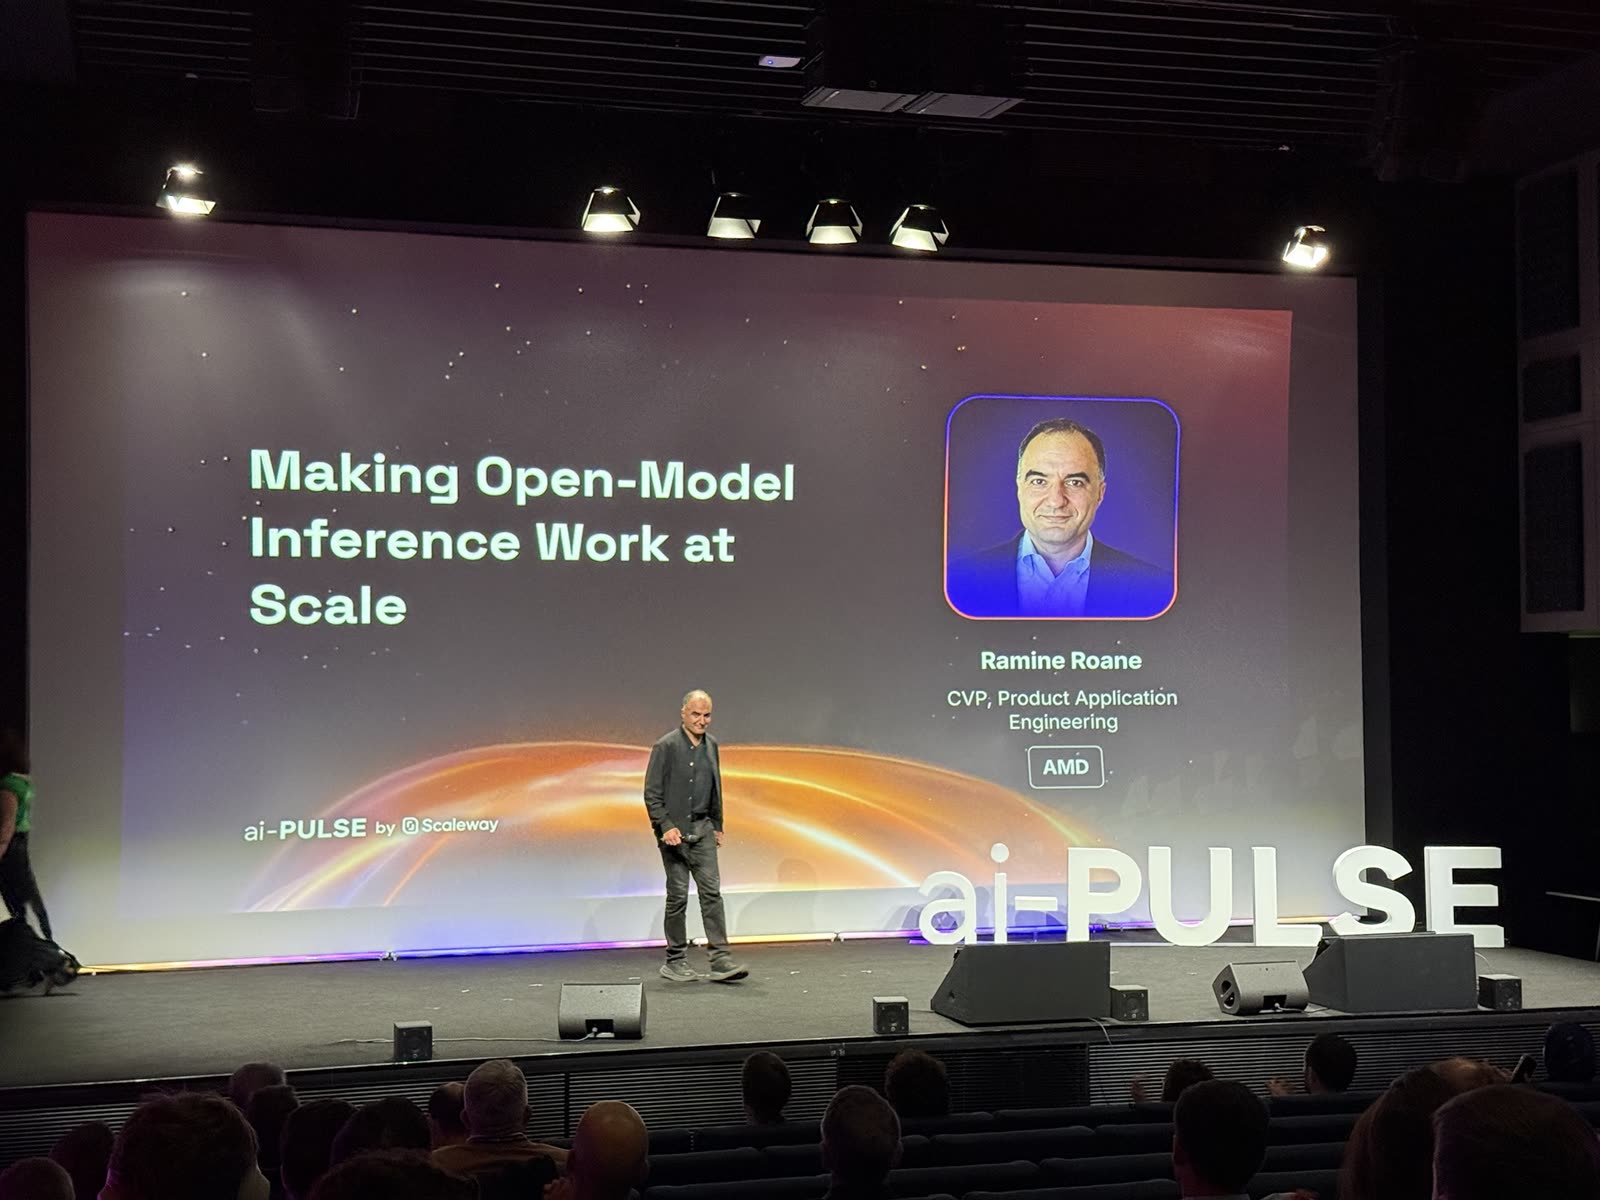
Le raisonnement de départ est simple. On loue un GPU, on y fait tourner un modèle open weight connu — Mistral, DeepSeek, MiniMax, GLM, Kimi — et on revend les tokens générés. Reste à savoir combien on en produit par seconde, et à quel coût. Pour servir les modèles, il a cité les frameworks classiques qui exploitent les GPU, dont vLLM.
Une équation, cinq leviers
Le revenu, ce sont les tokens facturables en entrée et en sortie. Le coût, c’est le compute, l’énergie, la plateforme et l’exploitation. La marge, c’est ce qui finance la croissance.
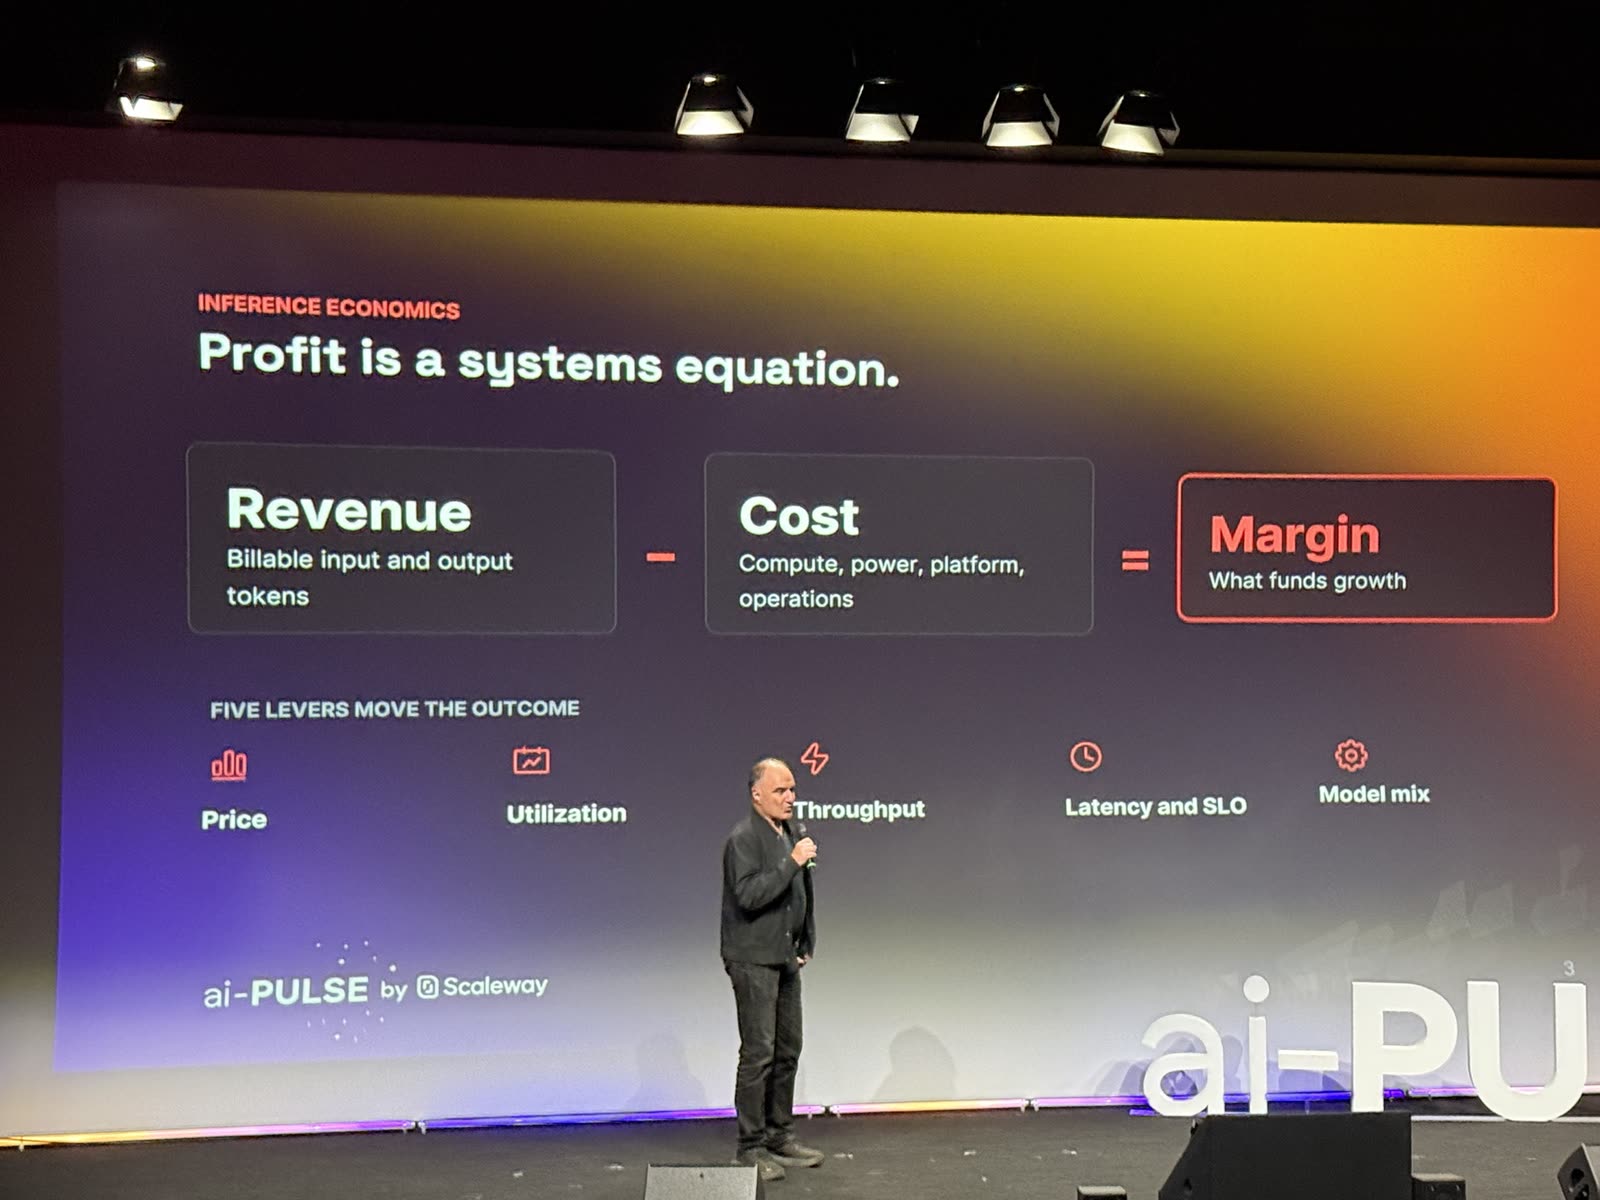
Cinq leviers déplacent le résultat : le prix, l’utilisation, le débit, la latence et les SLO, et le mix de modèles.
Deux d’entre eux se contredisent. L’interactivité se mesure en tokens par seconde et par utilisateur : c’est ce que perçoit la personne en face. Le débit se mesure en tokens par seconde et par GPU : c’est ce qui fait le revenu. Pousser le batch monte le débit et dégrade la latence ressentie. Réduire le batch fait l’inverse. Le point rentable est quelque part au milieu. Ramine Roane l’a situé autour de 60 tokens par seconde et par utilisateur, ce qui est déjà confortable à la lecture, pour une marge annoncée autour de 50 % une fois les redevances du fournisseur de modèle déduites.
Le matériel au service de cette équation
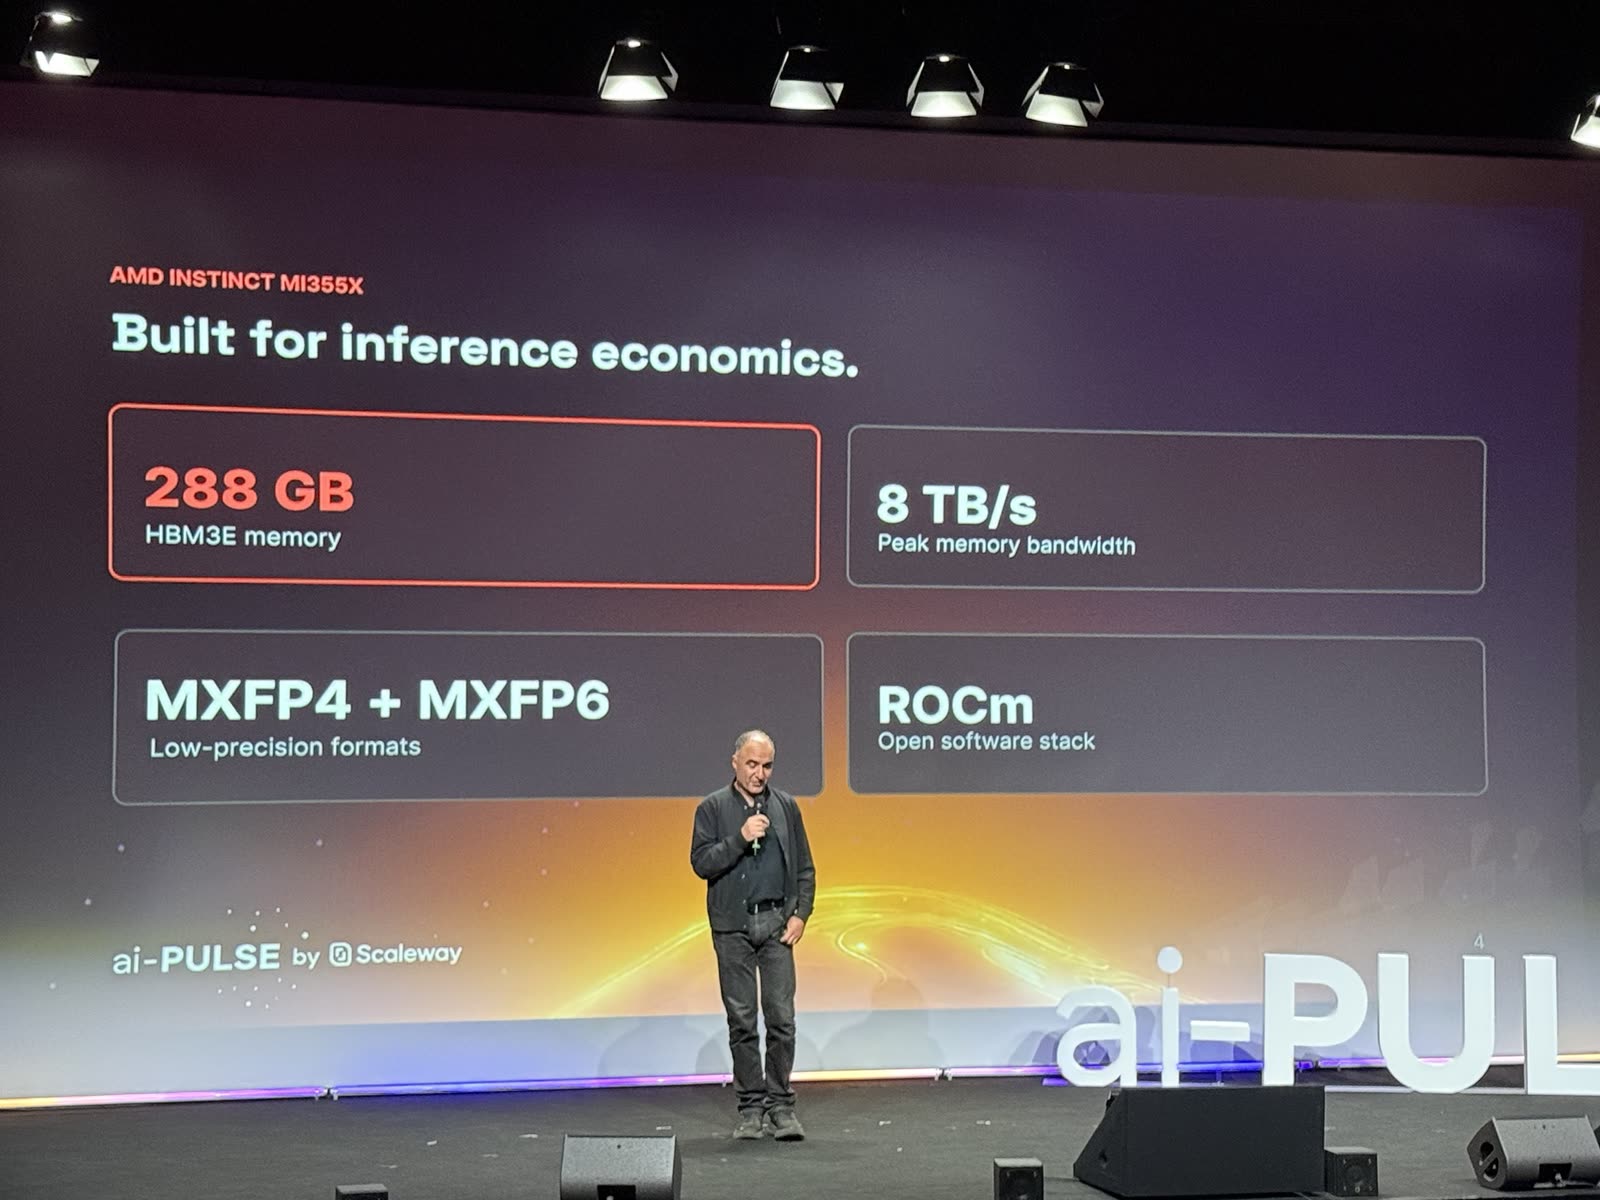
Côté AMD, l’Instinct MI355X est présenté comme conçu pour cette économie : 288 Go de mémoire HBM3E, 8 To/s de bande passante crête, les formats basse précision MXFP4 et MXFP6, et la stack logicielle ouverte ROCm.
La démonstration qui pique
Le slide le plus intéressant mesure le profit par puce et par heure, sur MiniMax M3 servi à 150 tokens par seconde et par utilisateur — le cas où l’utilisateur veut de la vitesse.
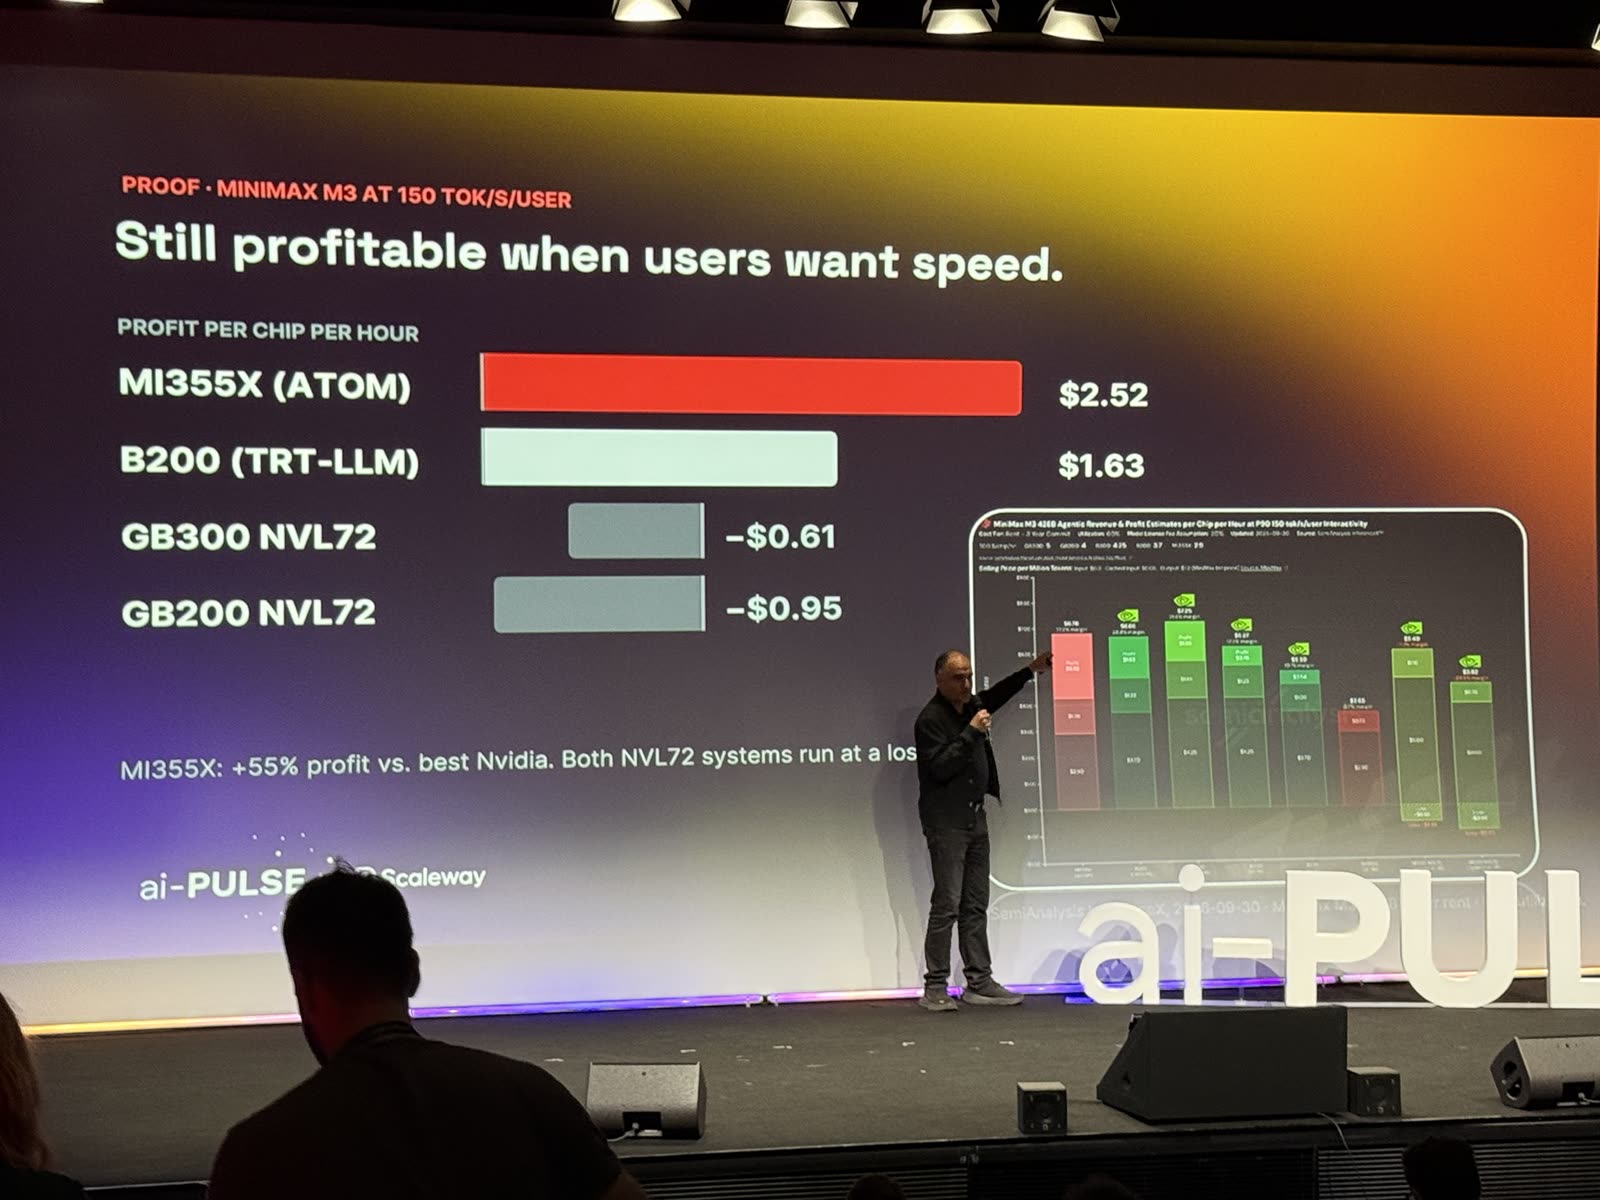
MI355X (ATOM) : +2,52 $. B200 (TRT-LLM) : +1,63 $. GB300 NVL72 : −0,61 $. GB200 NVL72 : −0,95 $. Entre parenthèses, le moteur d’inférence utilisé : ATOM, le moteur open source d’AMD, et TensorRT-LLM, celui de Nvidia. Le slide conclut : « MI355X: +55% profit vs. best Nvidia. Both NVL72 systems run at a loss. » Autrement dit, selon AMD et sur ce point de fonctionnement, deux systèmes parmi les plus chers du marché tournent à perte.
Il faut lire les hypothèses. Elles sont dans un encart en petits caractères, que j’ai relu sur ma photo : estimations SemiAnalysis InferenceX mises à jour le 30 septembre 2026, location sur engagement trois ans, utilisation de 60 %, redevance de licence du modèle de 20 %. C’est un slide AMD, les chiffres servent sa plateforme, et tout bascule si l’une de ces trois hypothèses bouge. Mais le chiffre à retenir n’est pas le profit : c’est l’utilisation. Avec 60 %, le GPU ne fait rien 40 % du temps. Quarante pour cent de la facture sans recette en face.
Le même problème, vu du réseau
Nokia est arrivé avec un autre angle, côté entraînement cette fois. Le message : la capacité à utiliser les GPU disponibles dépend de la vitesse du réseau. Le titre du slide : « The real constraint: GPUs waiting for the network. »
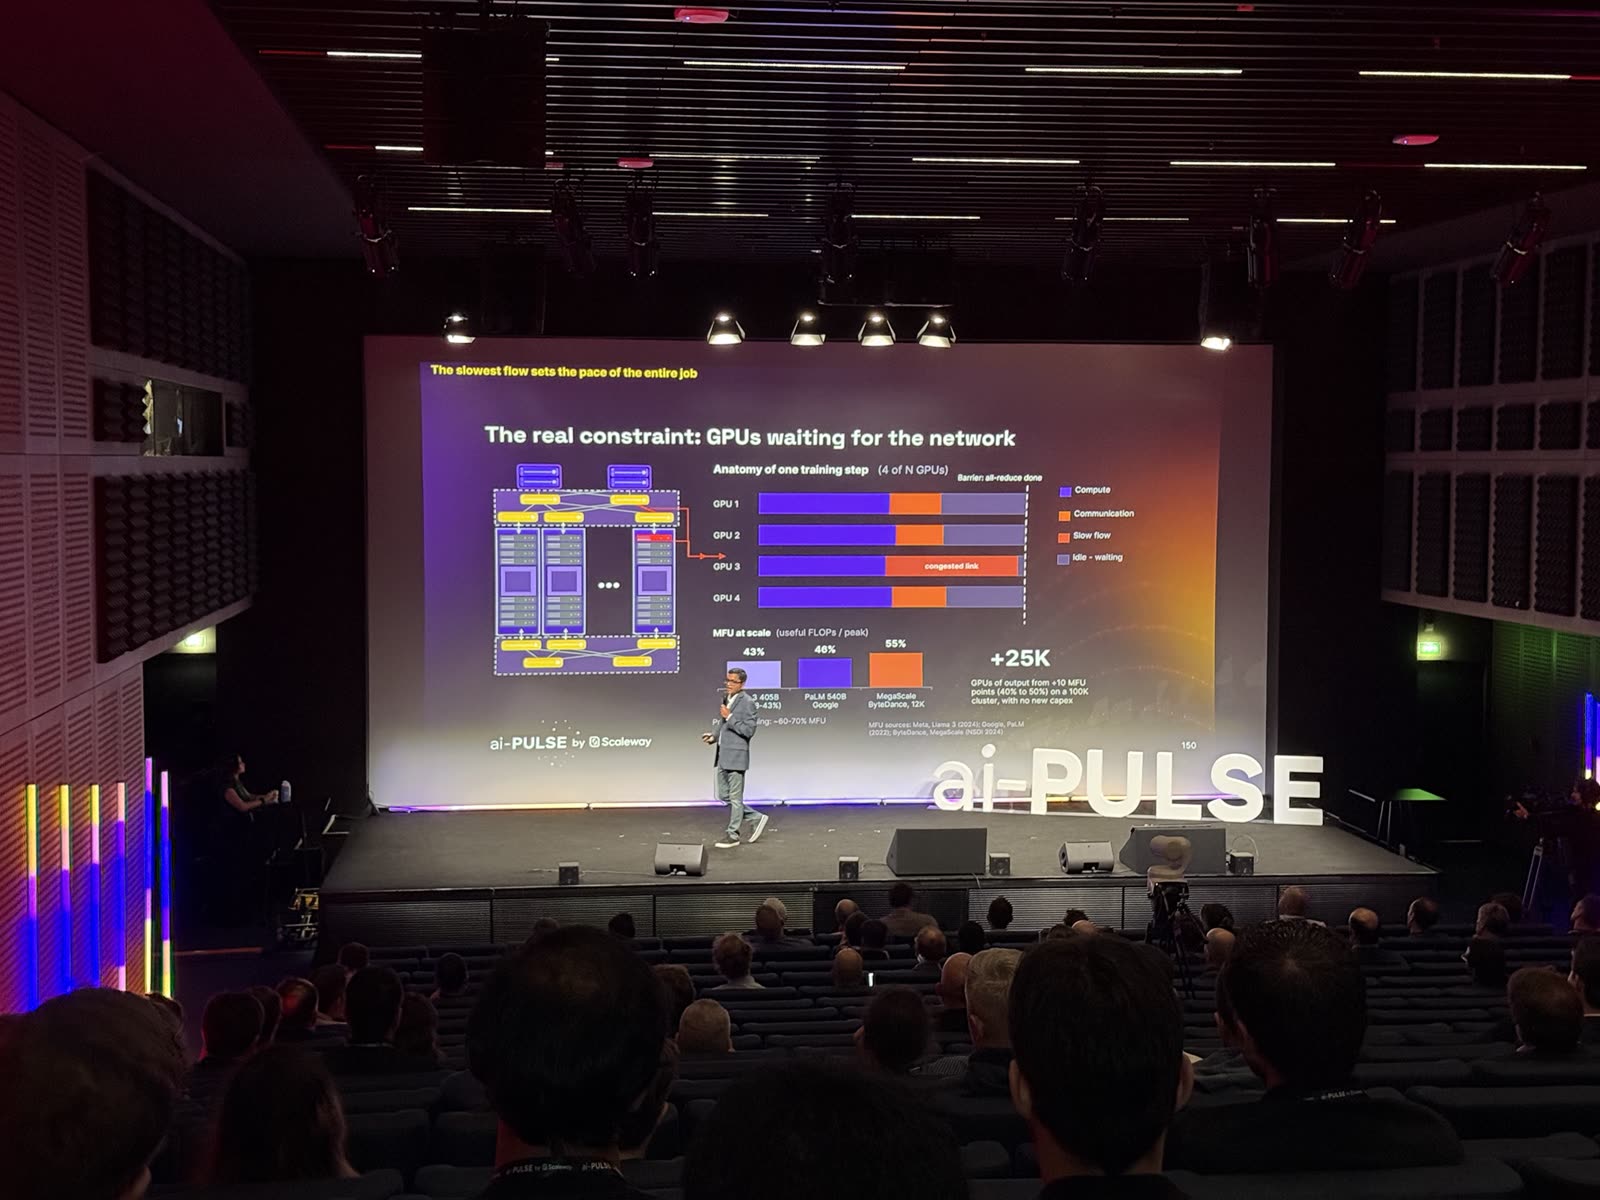
L’anatomie d’un pas d’entraînement se décompose en calcul, communication, puis attente jusqu’à la barrière de synchronisation. Un seul lien congestionné sur un GPU allonge sa phase de communication. Comme la barrière attend le plus lent, tous les autres restent à ne rien faire. Le flux le plus lent impose son rythme au job entier.
La mesure qui compte s’appelle le MFU, pour Model FLOPs Utilization : la part des FLOPs crête réellement utile. Llama 3 405B chez Meta, 43 %. PaLM 540B chez Google, 46 %. MegaScale chez ByteDance sur 12 000 GPU, 55 %. Le plafond pratique annoncé tourne autour de 60 à 70 %.
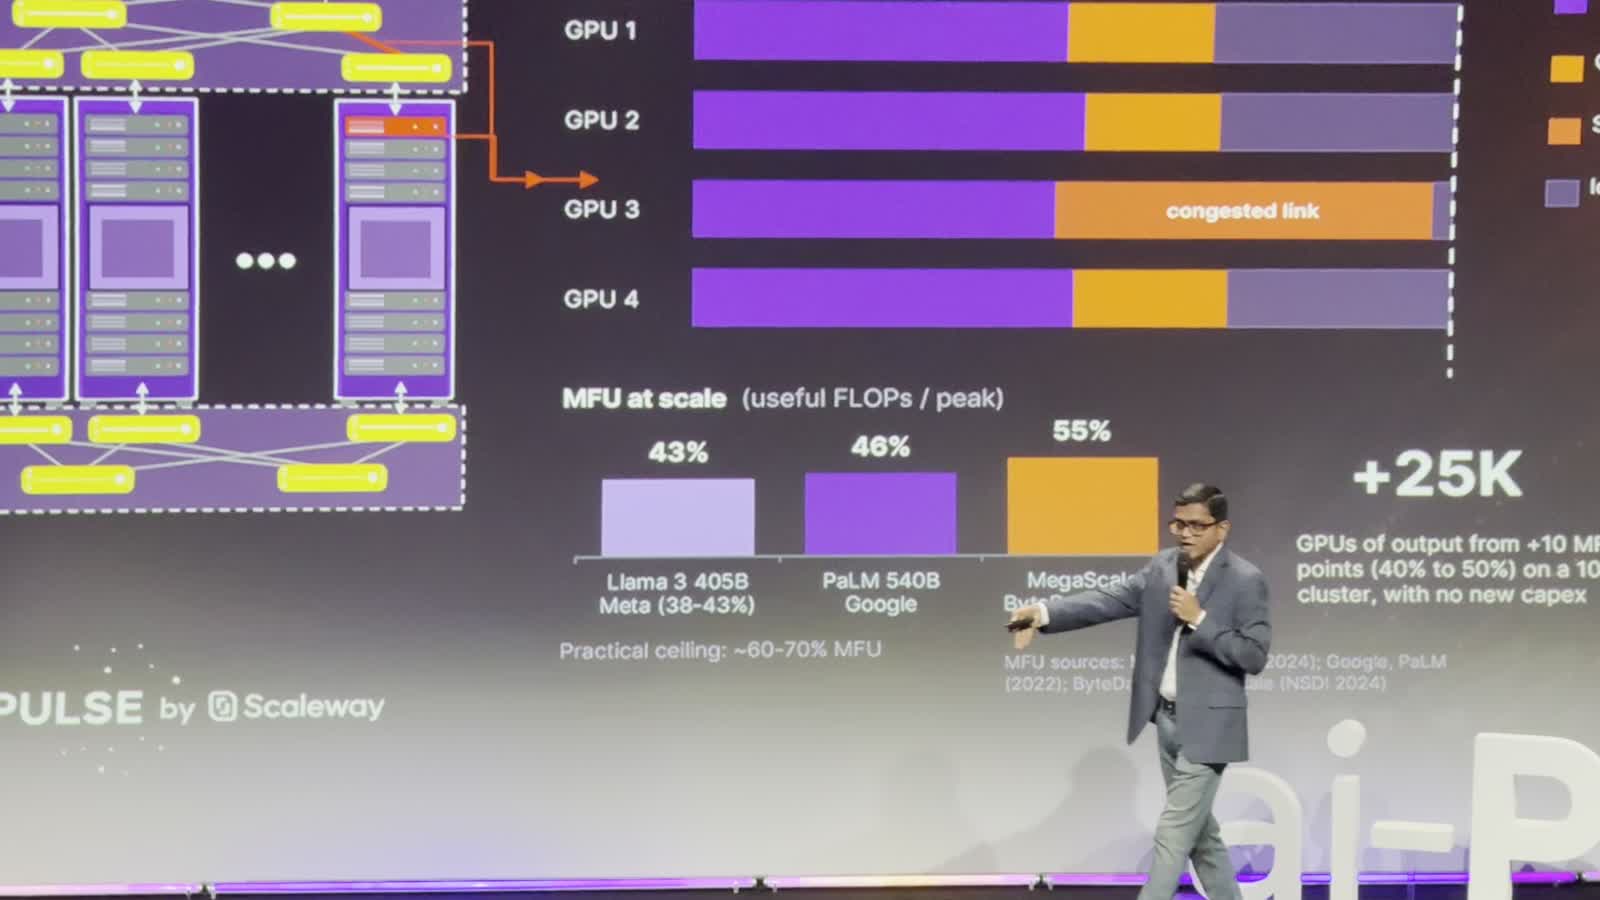
D’où l’argument qui porte : gagner 10 points de MFU, passer de 40 à 50 % sur un cluster de 100 000 GPU, équivaut à ajouter 25 000 GPU de production. Sans un euro de capex supplémentaire.
La réponse de Nokia : de la fibre partout, et moins de protocoles empilés. En substance : du silicium du switch au rack, du rack à la baie et jusqu’au plus près de l’endpoint, le cuivre ne tient plus.
Ce que j’en retiens
Occupation côté inférence, MFU côté entraînement. Le rapprochement est le mien, aucun des deux orateurs ne l’a fait sur scène. Mais ce sont deux mots pour la même chose : la puce est achetée, alimentée, comptée comme utilisée, et elle attend. Le coût d’un token ne se joue pas sur la carte, il se joue sur tout ce qui l’entoure — le réseau qui l’alimente, le runtime qui l’ordonnance, la demande qui la remplit.
Pour qui consomme de l’inférence plutôt que d’en vendre, ces chiffres ont une autre utilité : ils donnent l’ordre de grandeur du coût réel derrière le prix au million de tokens, et le seuil à partir duquel héberger son propre modèle commence à se discuter.